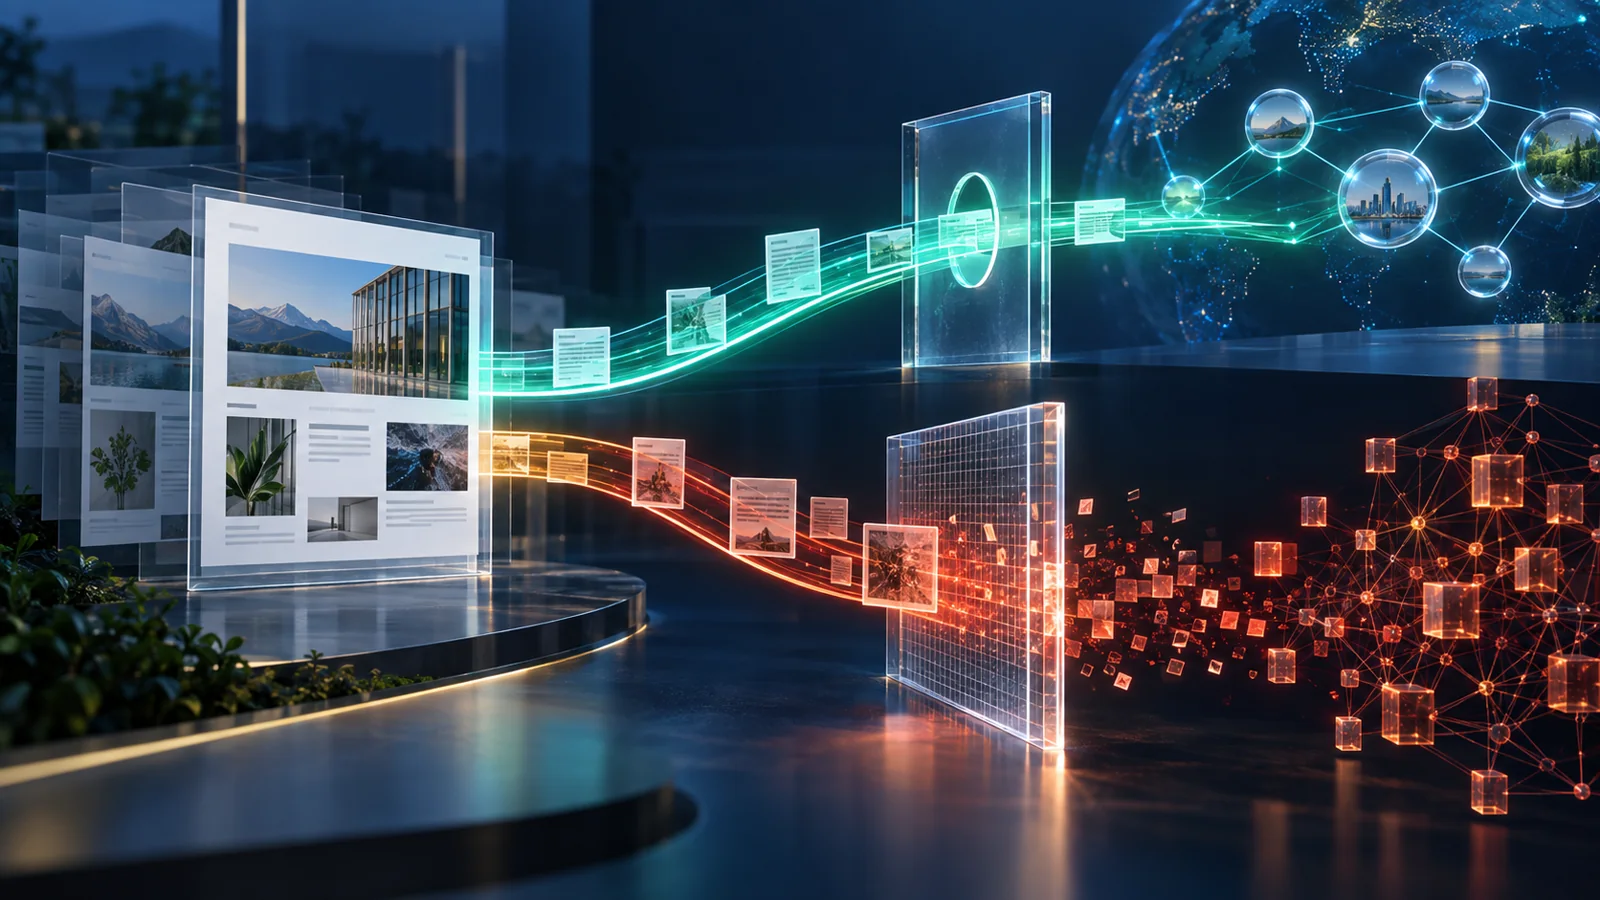
Un site de companie trebuie sa fie gasit in motoarele de cautare, dar aceleasi pagini pot fi accesate si pentru alte scopuri: antrenarea modelelor AI, generarea de raspunsuri sau actiuni executate de agenti. Daca firma blocheaza tot traficul automat, risca sa isi taie singura indexarea. Daca permite totul, nu mai are o politica reala pentru continutul in care a investit.
Pe 15 septembrie 2026, Cloudflare a anuntat pe X o setare noua, Disallow AI Training, conceputa pentru a separa indexarea de folosirea continutului la antrenare. Sursa primara explica un model mai util pentru firme: exprimi public preferinta, permiti crawlerelor de cautare care respecta separarea, blochezi tehnic traficul nepermis si verifici ce se intampla in realitate. Nu este doar o modificare de robots.txt, ci un mic sistem de guvernanta pentru continutul public.
Procesul in sase pasi pentru controlul crawlerelor AI fara pierderea vizibilitatii SEO
Urmărește procesul complet și folosește articolul de mai jos ca ghid de implementare.
Problema: acelasi crawler poate avea mai multe scopuri
Pentru proprietarul site-ului, o cerere automata arata initial ca trafic de bot. Diferenta de afaceri apare in scop: un motor poate indexa pagina pentru a afisa un titlu si un link, un serviciu poate colecta text pentru antrenare, iar un agent poate citi pagina la cererea unui utilizator. Aceste utilizari au efecte diferite asupra vizibilitatii, costului de infrastructura si controlului asupra continutului.
O regula generica de tipul blocheaza tot este simpla, dar poate fi scumpa. Documentatia Cloudflare arata ca setarea Block aplicata crawlerelor cu utilizare mixta poate opri inclusiv accesul pentru cautare. In sens invers, simpla publicare a unei preferinte nu garanteaza respectarea ei: conform documentatiei oficiale, robots.txt este voluntar si un operator il poate ignora. Firma are nevoie de doua straturi distincte, semnal si aplicare.
Solutia: separi cautarea, antrenarea si agentii
Modelul practic incepe cu trei politici la nivel de domeniu. Pentru Search decizi daca permiti indexarea clasica. Pentru Training stabilesti daca accepti folosirea continutului la antrenare sau ajustarea modelelor. Pentru Agent tratezi separat accesul instrumentelor care viziteaza pagina in numele unui utilizator. O alegere facuta pentru una dintre categorii nu trebuie copiata automat in celelalte.
Noua optiune anuntata de Cloudflare publica preferinta de neantrenare in robots.txt prin sincronizarea politicii si lasa active crawlerele mixte clasificate drept responsabile pentru componenta de cautare. Pentru crawlerii dedicati antrenarii, controlul poate aplica blocarea fara sa afecteze indexarea. Partea importanta pentru o firma nu este numele furnizorului, ci arhitectura: politica explicita, identificare dupa comportament, aplicare la marginea retelei si raportare.
Arhitectura practica in sase componente
Implementarea trebuie sa poata fi explicata si verificata de marketing, continut si echipa tehnica. Un fisier modificat fara responsabil, loguri sau test SEO nu este control, ci doar configuratie.
- Inventarul separa paginile publice, continutul premium, documentatia, imaginile originale si zonele care nu trebuie accesate automat.
- Matricea de politica noteaza pentru Search, Training si Agent ce este permis, refuzat sau conditionat si cine aproba schimbarea.
- Semnalul public din robots.txt exprima preferinta intr-o forma lizibila de crawler si pastreaza regulile clasice ale site-ului.
- Stratul de aplicare identifica tipul si comportamentul crawlerului, apoi permite, limiteaza sau blocheaza cererea conform politicii.
- Verificarea SEO testeaza robots.txt, paginile critice, indexarea si erorile raportate de instrumentele motoarelor de cautare.
- Jurnalul operational urmareste cererile permise si blocate, modificarile de configuratie si incidentele care cer revizuire.
Exemplu concret: magazin online cu fotografii si ghiduri proprii
Un magazin romanesc de mobilier investeste in fotografii originale, ghiduri de amenajare si descrieri realizate de specialisti. Traficul organic aduce cereri de oferta, deci indexarea trebuie protejata. In acelasi timp, firma nu vrea ca intregul catalog editorial sa fie colectat pentru antrenarea unor modele fara o decizie explicita.
Echipa inventariaza domeniul si alege politica: Search ramane permis pe paginile de categorie, produs si ghid; Training este refuzat la nivel de domeniu; Agent ramane permis pe paginile publice, dar limitat prin rata si blocat in cont, cos si configuratoare. robots.txt publica preferinta, iar controlul de retea aplica blocarea crawlerelor de antrenare cunoscute care nu au nevoie de acces pentru cautare.
Inainte de activare, firma salveaza nivelul de baza: pagini indexate, clicuri si impresii organice, cereri automate pe categorie si costul traficului. Dupa schimbare, verifica zilnic paginile cu valoare comerciala in prima saptamana si apoi saptamanal. Daca un motor important pierde acces, regula este corectata imediat; daca un crawler ignora preferinta, este trecut din monitorizare in blocare.
Implementarea minima pentru un pilot de cinci zile
Pilotul trebuie facut pe un singur domeniu si cu o cale clara de revenire. Nu incepe cu toate site-urile grupului si nu modifica regulile in ziua unei campanii majore.
- Ziua 1: exporta regulile existente, proprietarii tehnici, paginile cu trafic organic si principalele familii de crawlere observate.
- Ziua 2: scrie matricea Search, Training si Agent; marcheaza explicit zonele care raman interzise indiferent de tipul botului.
- Ziua 3: activeaza semnalul de neantrenare si controlul tehnic intr-un interval monitorizat, pastrand configuratia anterioara pentru revenire.
- Ziua 4: verifica robots.txt din exterior, accesul la paginile comerciale, sitemap-ul, raspunsurile serverului si rapoartele de indexare.
- Ziua 5: compara logurile, documenteaza exceptiile si stabileste pragurile care declanseaza alerta, corectia sau revenirea.
Limite si riscuri pe care trebuie sa le controlezi
robots.txt exprima o preferinta, dar nu este un mecanism de autentificare si nici o bariera tehnica. Un crawler care nu o respecta poate continua sa ceara pagini; de aceea, pentru aplicare reala ai nevoie de clasificare, reguli de retea si loguri. Nici identificarea nu este perfecta: agentii utilizatorilor, crawlerele noi sau traficul care isi ascunde identitatea pot necesita reguli suplimentare.
Compatibilitatea nu este uniforma. Sursa Cloudflare precizeaza ca Google si Apple au mecanisme distincte pentru excluderea de la antrenare, iar suportul Bing pentru preferinta la nivel de robots.txt este planificat pentru 2027; pana atunci exista controale separate. De asemenea, o regula pentru Training nu controleaza automat rezumatele AI sau accesul Agent. Firma trebuie sa trateze fiecare scop separat si sa revizuiasca politica pe masura ce standardele evolueaza.
Nu interpreta aceasta configuratie ca protectie juridica absoluta si nu publica in robots.txt cai secrete pe care nu vrei sa le divulgi. Continutul cu adevarat confidential nu trebuie sa fie public. Pentru materiale valoroase comercial, combina controlul crawlerelor cu autentificare, rate limiting, marcarea sursei, termeni de utilizare si o decizie interna documentata.
Cum masori daca politica produce valoare
Obiectivul nu este sa maximizezi numarul de boti blocati. O politica buna reduce colectarea nedorita fara sa deterioreze descoperirea continutului de catre clienti. Compara tendinta cu perioada de baza si urmareste schimbarile dupa fiecare ajustare.
- Clicuri, impresii si pagini indexate pentru cautarea organica, separat pe directoarele comerciale importante.
- Numarul cererilor de la crawlere de cautare permise si rata erorilor pe paginile care trebuie indexate.
- Cererile de antrenare refuzate prin semnal si cererile blocate tehnic dupa identificarea comportamentului.
- Volumul traficului automat necunoscut, costul de infrastructura si incidentele de clasificare gresita.
- Timpul necesar pentru audit, aprobarea modificarilor si revenirea la o configuratie functionala.
Nu trebuie sa alegi intre vizibilitate SEO si controlul folosirii continutului pentru antrenarea AI. Separa scopurile, publica preferinta, aplica tehnic politica, verifica indexarea si masoara continuu. robots.txt este inceputul conversatiei cu crawlerul, nu sfarsitul controlului.
Vrei sa controlezi crawlerii AI fara sa risti traficul organic?
AIPro poate proiecta un pilot pentru inventar, politica Search-Training-Agent, configurare, verificare SEO si monitorizare, adaptat site-ului firmei tale.
Discută cu AIPro →